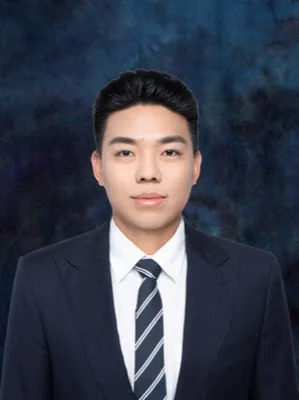
刘益萌

我是密歇根州立大学计算机科学与工程博士候选人,导师为曹志超老师。

我研究智能系统如何从不完整的观测中理解物理世界。已发表的工作以真实环境中的多模态感知与学习为基础。加入密歇根州立大学前,我在弗吉尼亚理工大学学习数学,并与 Rolf Müller 合作研究仿生声呐。

目前关注

空间智能:让系统知道什么在哪里、处于什么状态、正在如何变化、可以做什么——先是一个观察者,再到共享同一空间的多个观察者。

8 篇第一作者论文、3 篇已发表、1 篇在审、4 篇预印本

Yimeng Liu

2023 —计算机科学与工程博士候选人密歇根州立大学

2019 — 2023数学学士弗吉尼亚理工大学

动态与时间线

公开论文、研究报告与个人学术经历。

完整时间线

  • 我们的论文 UltraLEGO 将在 ACM MobiCom 2026 发表。
  • SPIRIT 预印本上线 arXiv:把稀疏孔径 SAR 视为物理约束的逆渲染问题。
  • Mimir 预印本上线 arXiv:面向长周期灌溉控制的物理约束 LLM 智能体。

核心论文与研究

塑造了我当前研究方向的代表工作。

  1. 2026arXiv'26

    SPIRIT: Sparse Physics-Informed Inverse Rendering for SAR Imaging

    Yimeng Liu, Maolin Gan, Jingkai Lin, Jialuo Du, Mi Zhang, Zhichao Cao

    arXiv preprint arXiv:2610.23914 (2026)

  2. 2026arXiv'26

    Mimir: Physics-Grounded LLM Agents for Long-Horizon Irrigation Control

    Yimeng Liu, Mi Zhang, Younsuk Dong, Zhichao Cao

    arXiv preprint arXiv:2610.02038 (2026)

  3. 2026Under review

    Snotra: Continually Adapting Irrigation World Models under Physical Change

    在审稿件 (2026)

  4. 2026arXiv'26

    AIoT-Based Continuous, Contextualized, and Explainable Driving Assessment for Older Adults

    Yimeng Liu, Fangwei Zhang, Maolin Gan, Jialuo Du, Jingkai Lin, Yawen Wang, Fei Sun, Honglei Chen, Linda Hill, Ruofeng Liu, Tianxing Li, Zhichao Cao

    arXiv preprint arXiv:2603.00691 (2026)

  5. 2025SenSys'25

    Proteus: Enhanced mmWave Leaf Wetness Detection with Cross-Modality Knowledge Transfer

    Yimeng Liu, Maolin Gan, Huaili Zeng, Yidong Ren, Gen Li, Jingkai Lin, Younsuk Dong, Xiaobo Tan, Zhichao Cao

    Proceedings of the 23rd ACM Conference on Embedded Networked Sensor Systems (2025)

  6. 2025INFOCOM'25

    Adonis: Neural-Enhanced Fine-Grained Leaf Wetness Sensing with Efficient mmWave Imaging

    Yimeng Liu*, Maolin Gan*, Gen Li, Younsuk Dong, Zhichao Cao

    IEEE INFOCOM 2025 — IEEE Conference on Computer Communications (2025) · 共同一作

  7. 2024MobiCom'24

    Hydra: Accurate Multi-Modal Leaf Wetness Sensing with mm-Wave and Camera Fusion

    Yimeng Liu, Maolin Gan, Huaili Zeng, Li Liu, Younsuk Dong, Zhichao Cao

    Proceedings of the 30th Annual International Conference on Mobile Computing and Networking (2024)

学术服务与交流

学术服务

程序委员会

  • IEEE DSAA 2025

受邀审稿

  • UbiComp / ISWC · UbiSense 2025
  • IEEE Internet of Things Journal
  • IEEE Transactions on Mobile Computing
  • IEEE Internet Computing
  • HAI 2025 · Poster track

会议与报告

  • 2025 · Irvine, CAACM SenSysProteus 报告
  • 2024 · Washington, D.C.ACM MobiComHydra 报告
  • 2024 · Purdue UniversityNSF Workshop on Sustainable Computing参会
  • 受邀报告,夏威夷大学马诺阿分校,2024 年 10 月
完整学术活动

智能如何进入物理空间

从一个传感器,到一个能理解自身的空间

以一个房间为例:一盆植物、一张桌子、一扇窗。机器分五步进入这个空间。选择每一步,看它带来了什么,又还做不到什么。

机器眼中的房间,分为五个阶段:传感器、感知模型、语言模型、具身智能、空间智能。 植物 · 湿? 桌子 窗户 “这盆植物可能需要浇水。” 共享模型
  1. 机器开始测量世界。

    信号无处不在,但没有理解。

  2. 学习把信号变成标签。

    一种任务、一个视角、一个地点的识别。

  3. AI 学会推理与解释。

    有知识而无身体:它从未进入过这个房间。

  4. 传感器、模型与身体闭合一个回路。

    一个智能体独自感知、决策、行动。

    传感器 + 模型 + 机器人 = 具身智能

  5. 空间与其中的智能体共享一个模型。

    整个房间都能感知、理解与行动。

    环境 + 多个智能体 + 共享模型 = 空间智能

核心观点

空间智能塑造我们的未来。

智能正在从文本走进房间、农田与道路。要在那里发挥作用,系统必须知道什么在哪里、处于什么状态、如何变化、可以做什么——并且越来越需要与共享同一空间的其他系统一起知道。

“他们会认为,真实不过是影像的投影。”

柏拉图《理想国》第七卷 · 洞穴之喻
科学一个逆问题
每个传感器看到的都是世界的投影:O = h(W) + ε。理解,就是追问哪一个世界能解释所有投影——以及哪些即使合在一起也仍不可观测。
哲学从影子到群体
柏拉图:我们看到的是投影。吉布森:感知是为了行动。亚里士多德与荀子:人因群居与共知而成为智慧的物种——“人能群,彼不能群也”。
工程一个回路,多种尺度
感知 → 理解 → 行动,跨越传感器、模型、身体与网络构建,并在假设失效之处接受检验。

研究 8 篇第一作者论文、3 篇已发表、1 篇在审、4 篇预印本

感知、理解、行动:为一个观察者闭合回路

回路的每个阶段都有自己的失败方式。我的第一作者论文各自回答其中一个阶段;每个阶段突出一篇代表作。

  1. 1感知

    关键状态往往是隐藏的。

    相机看不到水分与材质;任何单一传感器都会在某处失效。

    ACM MobiCom 2024

    Hydra

    融合毫米波 SAR 深度切片与相机图像,昼夜感知真实叶片上的水分。

    室内准确率约 96%,田间约 90%,包括雨天、黎明与弱光夜晚。

  2. 2理解

    稀疏证据可以对应许多个世界。

    快速感知意味着测量更少,而更少的测量能拟合许多种形状与含义。

    arXiv 2026

    SPIRIT

    把稀疏孔径雷达成像视为逆渲染:通过可见性、相位与传播的物理模型重建显式三维表面。

    数据采集减少 90% 以上,同时保持较低的几何与信号误差。

  3. 3行动

    物理世界没有重置键。

    行动改变未来状态,误差会累积,模型会过时。

    arXiv 2026

    Mímir

    物理落地的 LLM 智能体:语言提出方案,模拟器检验与修复,物理执行权留给固定的数值机制。

    灌溉用水比历史方案减少约 51%;更大的语言模型并不带来单调提升。

我怎样开展研究

延伸阅读 从测量到理解,中间发生了什么?

从问题出发,再选择模型。
先明确需要理解什么、做出什么决策,再决定如何建模。
始终回到观测与证据。
追问证据支持什么、无法区分什么,以及哪些假设将观测连接到物理状态。
检验假设失效的边界。
评估系统在哪些条件下有效、假设何时失效,以及系统能否识别证据已经不足。

下一步:从一个观察者到共享的空间智能

今天的智能生活在一座座孤岛上:田间传感器只看一片叶子,汽车只有一个视角,机器人只在一个房间,语言模型懂词语而不懂地点。一个观察者只是世界的一个稀疏孔径。我的下一步,是让观察者合并它们所看到、所相信和所做的——同时不放弃本地的执行权。

今天:感知与智能的孤岛

  • 田间传感器一片叶子,一个数值
  • 驾驶辅助一辆车,一个视角
  • 家庭机器人一个房间,一项任务
  • 语言模型懂词语,不懂地点

1共同观察

多个局部视角何时能确定单一视角无法确定的东西?

在传感器与智能体之间共享证据,并度量哪些状态只有在视角合并后才变得可辨识。

挑战:异构传感器之间的对齐、时序与带宽。

2共同相信

共享的信念应当如何修正——何时不应修正?

维护一个带显式不确定性的空间共同模型,只在证据支持时接受修正。

挑战:避免重复计算同一证据,处理相互冲突的来源。

3共同行动

谁可以依据共享的理解采取行动?

协调多个智能体的决策,同时让每个智能体的物理执行权保持有界且本地。

挑战:后果是物理的,安全、责任与隐私都必须被考虑。

桥梁:进行中的 AURA

AURA 通过多路数据理解同一个驾驶情境——驾驶员行为、车辆状态、道路与天气——跨越行程与年份。它的下一个测试是一个被遮挡的路口:路侧单元看到了一辆车看不到的行人,另一辆车补充一个视角,而最终决策仍由这辆车做出。

AURA

共享何时更好?

并非总是如此。观察者互补时共享有益,冗余时收益很小,同一证据被重复计算时甚至有害。度量一个空间处于哪种状态,本身就是科学问题的一部分。

继续 研究方向与路线

交流与联系

欢迎交流多模态感知、物理表征与可靠智能系统,也期待与领域研究者合作,讨论具体测量问题。

liuyime2@msu.edu

履历学术服务